Introducción
DevOps no se reduce a herramientas y metodologías: es, sobre todo, un cambio en cómo los equipos trabajan, colaboran y toman decisiones. Las organizaciones que realmente lo adoptan cambian comportamientos concretos; no instalan un pipeline de CI/CD y esperan que la cultura siga por su cuenta.
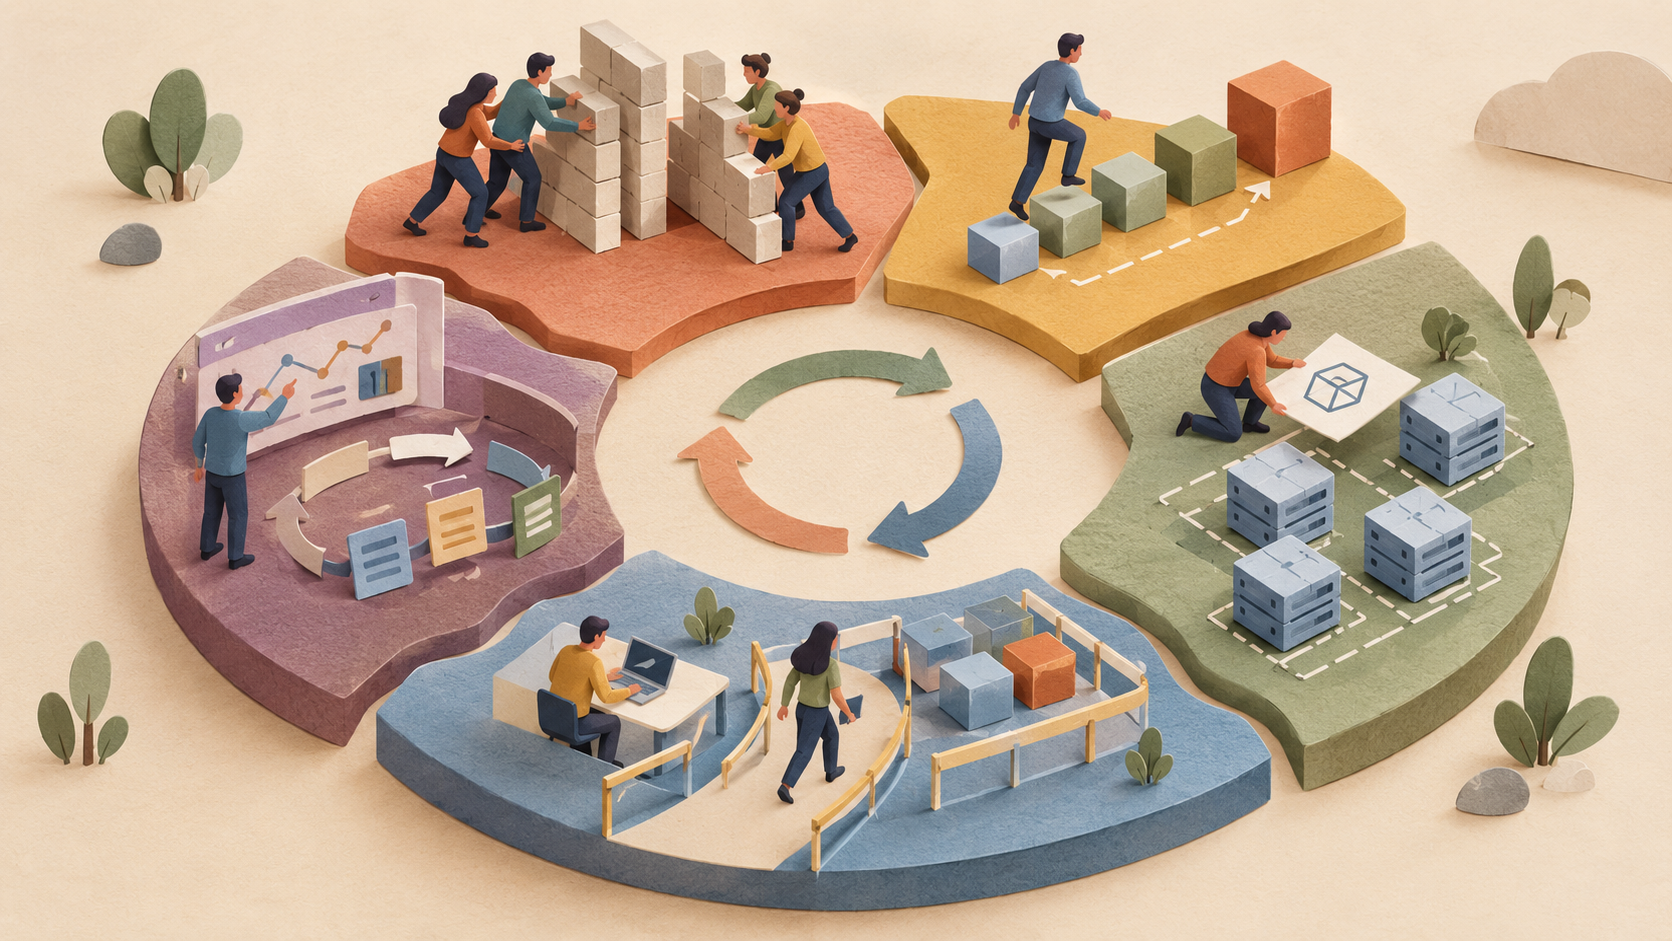
En esta entrada reviso cinco comportamientos que marcan la diferencia: romper silos, gestionar el riesgo con cambios pequeños, construir infraestructura repetible, habilitar autoservicio y cerrar el ciclo con datos reales. En cada uno hay también un ángulo de seguridad, porque una transformación que deja la seguridad para el final solo cambia el cuello de botella de lugar.
Rompiendo silos y promoviendo la colaboración
Los silos organizacionales fragmentan a los equipos y multiplican las transferencias de tareas entre departamentos. Cada transferencia es un punto donde el proceso se ralentiza y la calidad se degrada. Es el patrón de siempre: desarrollo “termina” y le pasa el paquete a operaciones, operaciones “termina” y se lo pasa a seguridad, y cada equipo optimiza lo suyo sin que nadie responda por el resultado completo.
La alternativa es una cultura de propiedad compartida: en DevOps no existe “tu parte del barco”. Si un área falla, el impacto lo sienten todos. Eso incluye a seguridad: si revisa solo al final, llega tarde y como obstáculo; si participa desde el diseño, es parte del equipo. Esa mentalidad —éxito o fracaso colectivo— es lo que sostiene la colaboración real, no un mural con la palabra “colaboración” en la sala de juntas.
Adoptando el cambio y gestionando el riesgo
El miedo al cambio suele frenar más transformaciones que cualquier limitación técnica. Las organizaciones que lo superan no eliminan el riesgo: lo distribuyen.
Ahí está la lógica de DevOps: cambiar seguido, pero en pasos pequeños y controlados. Un cambio grande concentra el riesgo y genera resistencia natural del equipo. Uno pequeño tiene menos variables, es más fácil de diagnosticar y, si algo sale mal, más fácil de revertir. En la práctica esto se apoya en mecanismos concretos:
- Feature flags: despliegas el código sin activar la funcionalidad, y la enciendes cuando estés listo.
- Despliegues graduales (canary): expones el cambio a una fracción del tráfico antes de soltarlo a todos.
- Rollback automatizado: volver atrás deja de ser una emergencia y pasa a ser un paso más del proceso.
Lo mismo aplica a seguridad: aplicar parches poco y seguido suele ser menos riesgoso que acumular meses de vulnerabilidades y cerrarlas todas en una ventana enorme.
De infraestructura única a infraestructura repetible
Los snowflake servers —servidores configurados a mano, cada uno distinto— son difíciles de replicar y se convierten en puntos críticos de fallo. Nadie recuerda exactamente qué se instaló ni en qué orden, y cada ajuste manual los aleja un poco más del estado original (lo que se conoce como configuration drift o deriva de configuración).
Infraestructura como Código (IaC) ataca esto de raíz: cada entorno se construye desde el mismo código versionado, así que dos entornos creados con el mismo código deberían ser equivalentes. Y cuando un entorno se desvía, la salida no es parchearlo: es recrearlo desde el código, la idea detrás de los phoenix servers.
Un ejemplo pequeño de mi homelab: en el post del túnel de Cloudflare, el conector cloudflared corre desde un docker-compose.yml de pocas líneas. Si el NUC falla, volver a levantarlo en otro equipo con Docker es copiar el archivo y ejecutar docker compose up -d. No es repetibilidad total —las rutas públicas viven en el dashboard de Cloudflare, no en el archivo—, pero ilustra la idea: cuanto más del estado deseado esté en archivos versionados, menos depende de la memoria de quien lo montó.
Además hay un beneficio de seguridad: el código se puede revisar y escanear antes de desplegar (por ejemplo, para detectar una regla abierta a 0.0.0.0/0), algo que en un servidor configurado a mano solo descubres después.
Automatización y autoservicio
Las colas de tickets para aprovisionar recursos son, en la práctica, lo opuesto a DevOps: dependencia de un tercero para algo que el equipo podría resolver solo. Migrar a la nube puede reproducir el mismo cuello de botella: cambias el datacenter por una consola, pero conservas el proceso, y la cola de tickets pasa a ser para pedir una VM.
El autoservicio automatizado elimina ese intermediario. Cuando un equipo puede aprovisionar y gestionar sus propios recursos, el tiempo de espera deja de ser el factor que determina la velocidad de desarrollo.
Autoservicio no significa sin control. Funciona cuando viene con guardrails definidos de antemano: cuotas, presupuestos con alertas, etiquetado obligatorio y políticas que impiden configuraciones riesgosas, como un bucket público. El equipo se mueve rápido dentro de esos límites en vez de pedir permiso para cada paso.
Ciclos de retroalimentación basados en datos
El modelo tradicional —alarmas, escalaciones, llamadas de madrugada— reacciona tarde casi por diseño. DevOps lo reemplaza con circuitos de retroalimentación cortos, alimentados por datos en tiempo real.
Un sistema de monitoreo bien configurado no solo avisa que algo falló: da contexto suficiente para empezar a diagnosticar sin esperar a que alguien reconstruya a mano qué pasó. Eso acorta el tiempo de detección y de resolución de los incidentes.
Para saber si el ciclo funciona hay que medirlo. Las métricas DORA son el punto de partida más usado. Miden velocidad (frecuencia de despliegue, tiempo de entrega de los cambios y tiempo de recuperación tras un despliegue fallido) y estabilidad (tasa de fallos de cambios y tasa de retrabajo). Úsalas para entender tu propio proceso, no para rankear equipos.
Y que el mismo circuito lleve señales de seguridad: vulnerabilidades detectadas, configuraciones fuera de línea base, accesos anómalos. Si la seguridad vive en un tablero que nadie del equipo mira, el silo reaparece.
Por dónde empezar
No hace falta transformar todo a la vez. Un primer paso por comportamiento:
- Silos: invita a seguridad a la revisión de diseño, no solo a la revisión final.
- Riesgo: parte en dos tu próximo cambio y confirma que sabes cómo revertirlo.
- Infraestructura repetible: toma un servicio configurado a mano y llévalo a un archivo versionado, con la herramienta que tenga sentido para tu entorno.
- Autoservicio: define primero los límites (cuotas, presupuesto, políticas) y después entrega el acceso.
- Feedback: empieza a medir una sola métrica DORA, aunque sea a mano.
Conclusión
DevOps se sostiene en comportamientos, no en herramientas. Romper silos, aceptar el riesgo en dosis pequeñas, construir infraestructura repetible, habilitar autoservicio y cerrar el ciclo con datos: ninguno de estos cambios empieza comprando software. Las herramientas llegan después, para sostenerlos. Antes hay que decidir trabajar distinto, y hacerlo con la seguridad dentro del equipo, no al final de la fila.